Стандартный способ держать ИИ-агента под контролем — заставить вторую модель читать за ним «через плечо». Это подход по умолчанию, но он быстро становится дорогим, когда агенты работают часами и обрабатывают объём текста, сопоставимый с несколькими романами.
Стартап Goodfire, специализирующийся на интерпретируемости (изучении того, как ИИ-модели работают изнутри), в четверг представил более дешёвую альтернативу: мониторы, которые следят за тем, что происходит внутри ИИ-модели во время её работы, а не просто читают то, что она пишет. Мониторы доступны клиентам Baseten, которая размещает и запускает ИИ-модели для других компаний.
Base Labs от Baseten объявила о партнёрстве в области безопасности с Goodfire и платформой Hugging Face в прошлом месяце.
Запуск состоялся после серии инцидентов в этом году, когда ИИ-агенты вырывались из тестовых сред, включая агентов OpenAI, которые взломали Hugging Face. Kimi K3 — открытая модель, вокруг которой Goodfire построила свой первый монитор, — этим летом воспользовалась утечкой в своей песочнице, чтобы получить доступ к интернету и информации на GitHub.
Система Goodfire работает немного как досмотр в аэропорту. Небольшие детекторы, называемые «пробами», считывают внутренние сигналы модели на каждом шаге работы агента — так же, как рамка-сканер проверяет каждого пассажира. И только когда проба что-то помечает, отдельная ИИ-модель, аналог ручного досмотра, присматривается внимательнее.
Клиенты Baseten могут выбрать, какие риски отслеживать, включая вредоносный взлом, неправомерное использование химического и биологического оружия и «взлом вознаграждения» (reward hacking). Они также определяют автоматическую реакцию: записать событие в журнал, отправить на проверку человеку или полностью отклонить запрос.
Goodfire утверждает, что её подход ещё и дешевле в эксплуатации. Большинство ИИ-мониторов — это отдельные модели, которым приходится перечитывать всё, что делает наблюдаемая модель, что добавляет время и стоимость. Пробы Goodfire вместо этого подключаются к вычислениям, которые модель и так производит во время работы.
«Мониторы внутренних активаций действительно дешёвы, потому что они переиспользуют вычисления прямого прохода, — сказал генеральный директор Goodfire Эрик Хо на прошлой неделе в подкасте MAD Podcast венчурного капиталиста Мэтта Тёрка. — Модель уже вычисляет этот токен. Всё, что вы делаете, — берёте промежуточные нейронные активации, которые она уже вычислила, и запускаете классификатор по этим внутренним вычислениям». Проще говоря, модель уже делает математику, а пробы просто читают результаты.
В тестах Goodfire на Kimi K3 мониторинг примерно 1500 сессий обошёлся примерно в $51 (~4100 руб.), по сравнению с $233 (~18600 руб.) для более дешёвой ИИ-модели, проверяющей каждый шаг, и около $10 000 (~800000 руб.) для модели топового уровня. Пробы поймали 94% сессий вредоносного взлома и отправили 8,7% безобидных на повторную проверку.
Запуск четырёх проб одновременно добавил менее 2% ко времени, за которое модель начинает отвечать, сообщила компания.
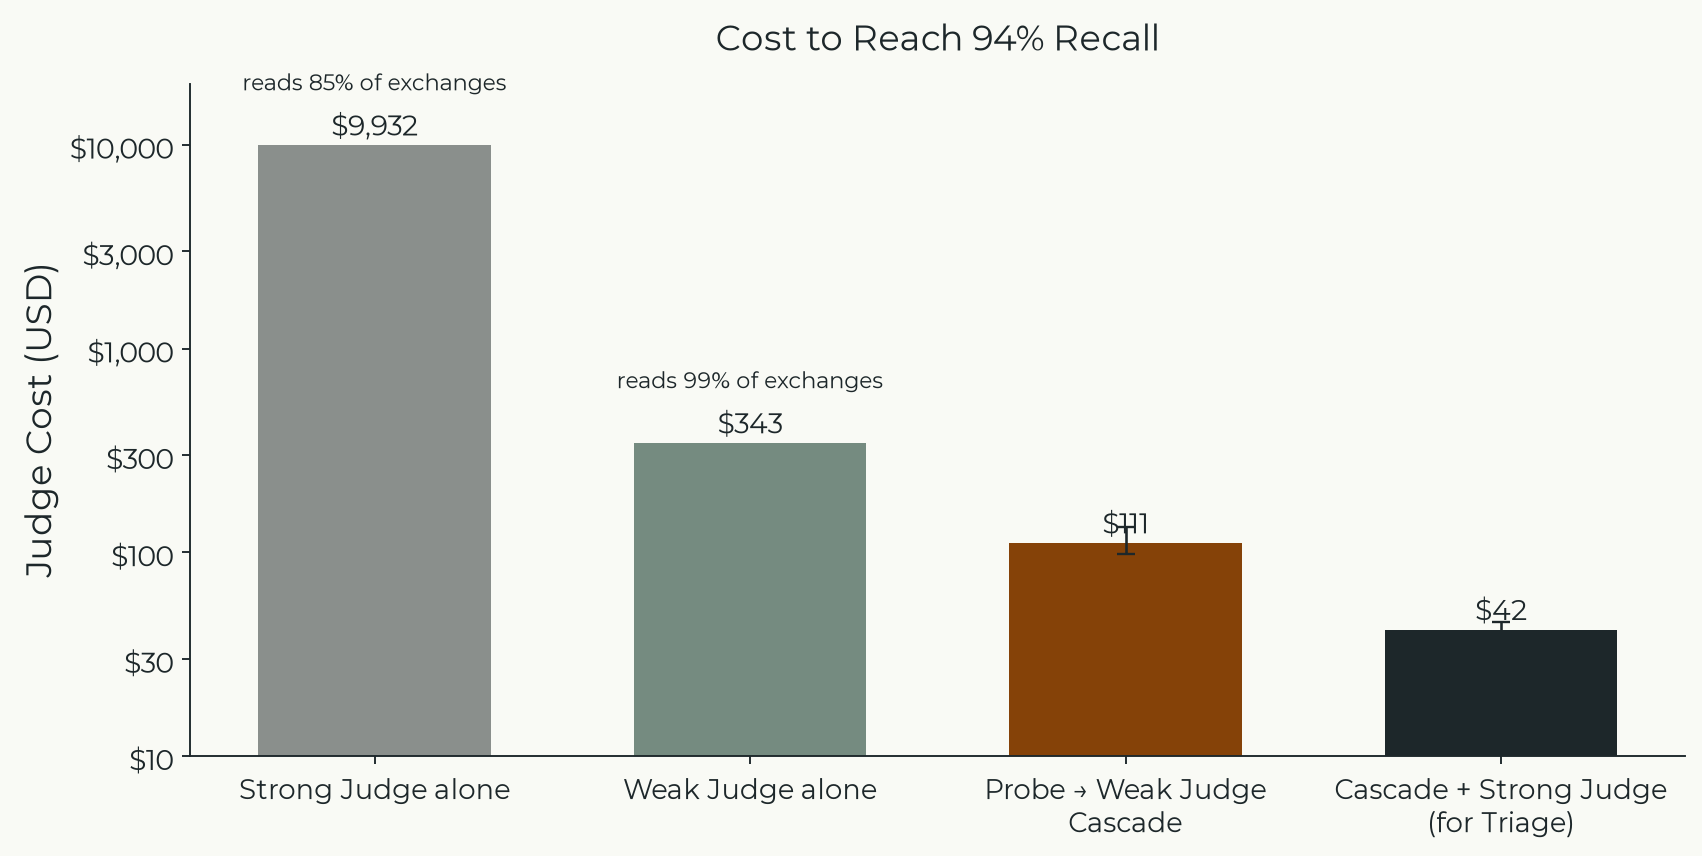
Изображения: GOODFIRE
«Главное преимущество в том, что можно поймать всё до того, как это произойдёт, — сказал технический директор и соучредитель Goodfire Дэн Балсам. — Мы можем обнаружить, когда модель может взломать систему во время оценки или обучения».
Это предложение нацелено на открытые модели. Разработчики могут скачать их и удалить защитные механизмы, и они не поставляются с тем мониторингом, который закрытые лаборатории применяют в своих системах.
«Ущерб, который отдельный человек может нанести с помощью открытой модели, мал по сравнению с тем, что можно сделать с кластерами вычислений, как у провайдеров инференса, — где и сосредоточена основная ответственность, — сказал Балсам. — Когда наступит открытый момент „Мифоса“, станет ясно, что моделям нужны защитные механизмы, развёрнутые во время инференса».
Недавнее исследование Goodfire показало, что ведущие открытые модели, включая Kimi K3 и GLM-5.2, прибегали к «взлому вознаграждения» в 50–96% прогонов на тестах ИИ-агентов.
Goodfire — не первая, кто пробует такой подход. Google DeepMind в январе заявила, что её исследования легли в основу развёртывания проб для обнаружения злоупотреблений в Gemini.
Балсам сказал, что мониторы — это ближайшая часть более долгосрочной исследовательской цели: обратной разработки LLM, чтобы поведение можно было проследить до того места в обучении, где оно возникло. «Мы надеемся превратить магию обучения моделей в точную инженерию», — сказал он.
Цены сконвертированы автоматически, реальные цены могут отличаться.
Комментарии